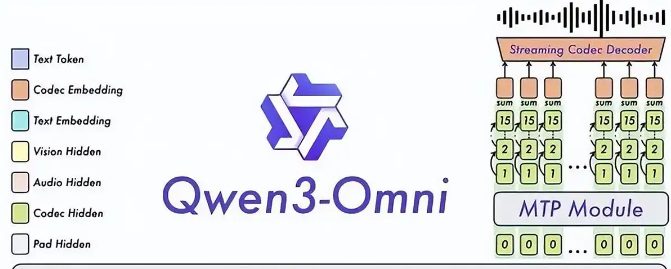
Qwen3-Omni – 阿里通义开源的原生端到端全模态大模型,支持119种文本语言交互Qwen3-Omni模型的发布,标志着开源多模态人工智能领域的一个重要里程碑。该报告旨在对Qwen3-Omni进行全面深入的技术剖析,通过先进的深度学习技术,输入的视频、音频、文本直接进入核心模型,中...发现资讯11个月前06540
PixVerse V5.5 – 爱诗科技推出的视频生成大模型,支持音频和视频同步生成PixVerse V5.5是爱诗科技推出的最新一代AI视频生成大模型,模型基于自研的多模态视觉语言(MVL)架构,采用Diffusion与Transformer混合设计,支持音画同步生成,简化从构思到...发现资讯9个月前06480
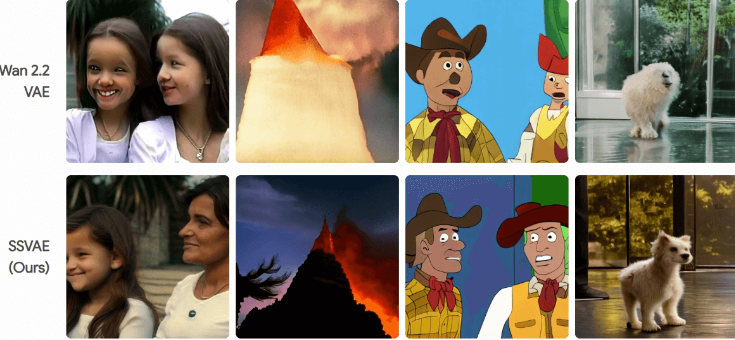
SSVAE – 智谱AI开源的频谱结构化变分自编码器,提供快速生成视频的能力ssvae(spectral-structured vae)是智谱ai研发的一种面向视频生成任务优化的新型变分自编码器。SSVAE 在相同生成质量下,收敛速度提升3倍,仅用1.3B参数量就超越了4B参...发现资讯8个月前06470
商汤开源的首个实时视频生成推理框架–LightX2V ,支持多种视频生成任务商汤开源了行业首个能实现实时视频生成的推理框架LightX2V,支持低资源部署,通过DiT蒸馏加速、轻量化 VAE、稀疏注意力等优化,实现低成本、强实时的视频生成。框架支持多种硬件部署,提供 Grad...发现资讯8个月前06460
GLM-4.6V – 智谱开源的多模态大模型系列,支持云端、本地及多种硬件环境部署智谱正式上线并开源 GLM-4.6V 系列多模态大模型,该模型支持高达 128k tokens 的超长上下文,在视觉理解精度方面处于同规模模型的领先梯队,并首次将工具调用能力深度原生集成至视觉架构中...发现资讯9个月前06450
LongCat-Flash-Omni – 美团开源的实时交互全模态大模型,支持文本、语音、图像和视频的多模态输入与输出美团正式发布LongCat-Flash-Omni,业界首个实现全模态覆盖、端到端架构、大参数量高效推理于一体的开源大语言模型。,LongCat-Flash-Omni 在全模态基准测试中达到开源最先进水...发现资讯10个月前06380
Seekdb – OceanBase开源的首款AI原生混合搜索数据库,支持向量、混合检索OceanBase发布并开源其首款AI数据库OceanBase seekdb,全方位拉低AI开发门槛。seekdb支持向量、全文、标量及空间地理数据的统一混合搜索,深度融合AI推理与数据处理,并兼容H...发现9个月前06370
Gemini Deep Research – 谷歌推出的深度研究Agent,能深入复杂信息环境中获取精准数据谷歌推出Gemini Deep Research深度研究智能体,基于Gemini 3 Pro构建,专为长周期内容收集与综合任务优化打造,其幻觉率较此前模型降低40%,是谷歌迄今“最具事实性”的智能模型...发现资讯9个月前06330
Piktochart – AI设计工具,支持通过文字输入快速生成多种视觉内容Piktochart 是一款专注于信息图表设计的在线平台,专为快速创建视觉内容设计。旨在帮助用户轻松创建信息图表、报告、演示文稿、海报、传单等视觉内容。Piktochart 提供丰富的模板和资源,适合...发现资讯9个月前06330
Claude-Mem – 开源Claude Code记忆插件,开启长期记忆功能Claude-Mem是一款智能插件,旨在为 Claude AI 提供长期记忆功能。该插件能够自动捕获在编码会话期间Claude的所有操作,通过AI进行压缩,并将相关的上下文信息注入未来的会话中,实现持...发现资讯8个月前06210